Pelatihan Associate Data Science Bersama Dosen Universitas Negeri Jember
Peserta
Periode
Skema
Sektor
Pelaksanaan
Latar Belakang
Riset dan pengajaran di perguruan tinggi kini semakin bertumpu pada kemampuan mengolah data secara sistematis untuk menghasilkan temuan yang valid dan dapat dipertanggungjawabkan. Namun kompetensi data science mulai dari eksplorasi data, penerapan algoritma machine learning, hingga interpretasi hasil model belum menjadi keahlian yang merata dimiliki oleh dosen lintas bidang keilmuan, meski kebutuhan akan analisis berbasis data terus meningkat baik untuk publikasi ilmiah maupun pengambilan keputusan akademik.
Untuk menjawab kebutuhan ini, kami menghadirkan Pelatihan Associate Data Science secara online yang dirancang berbasis metodologi CRISP-DM (Cross-Industry Standard Process for Data Mining), standar industri yang telah teruji untuk memandu proses analisis data secara terstruktur
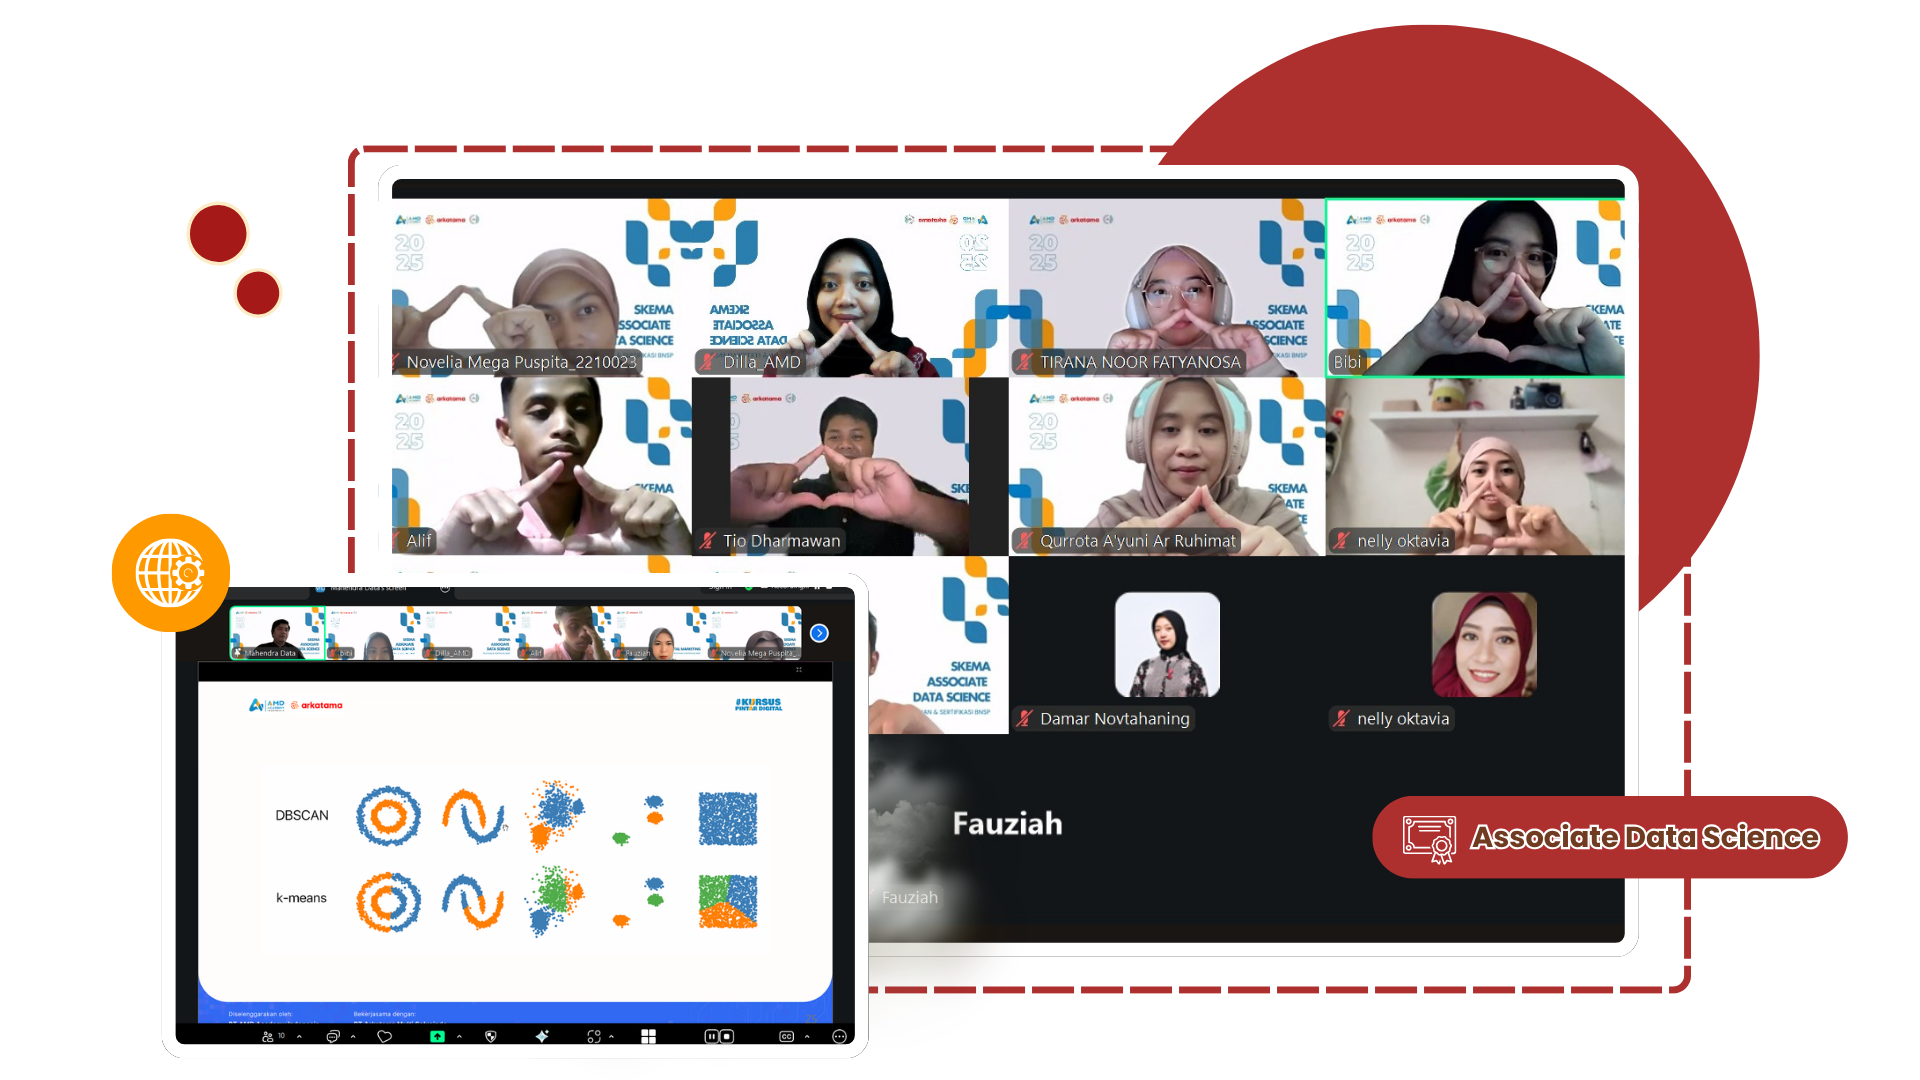
Tentang Peserta
Tantangan
Solusi
Dokumentasi
Materi
- Pengantar Data Science, CRISP-DM Framework, Data Mining, dan Machine Learning
- Business and Data Understanding
- Menelaah Data (Exploratory Data Analysis/EDA)
- Memvalidasi dan Membersihkan Data
- Konsep Dasar Machine Learning
- Supervised Learning: Klasifikasi
- Supervised Learning: Regresi
- Supervised Learning: Peramalan
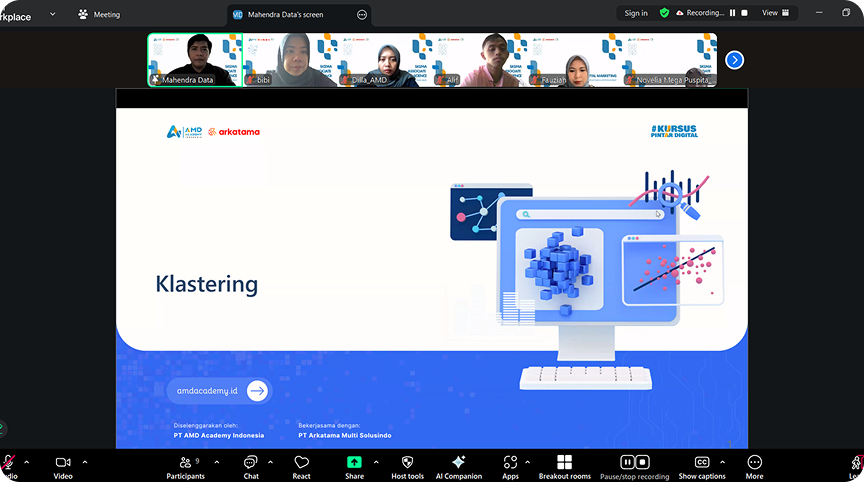
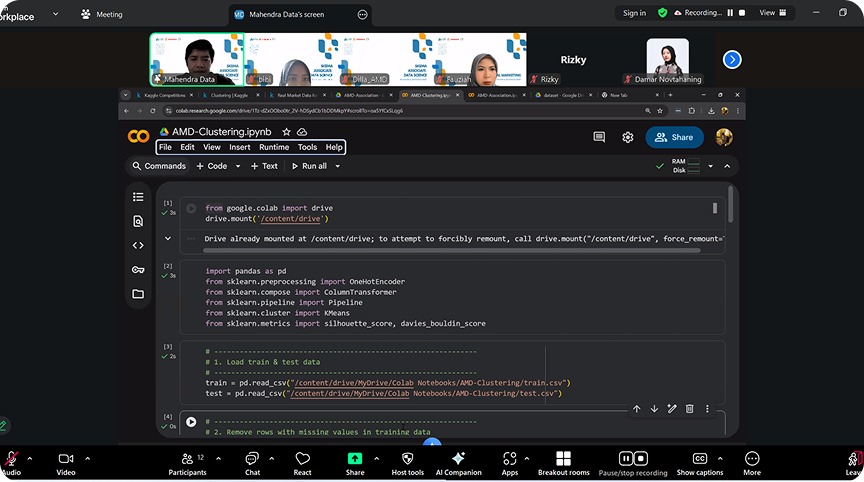
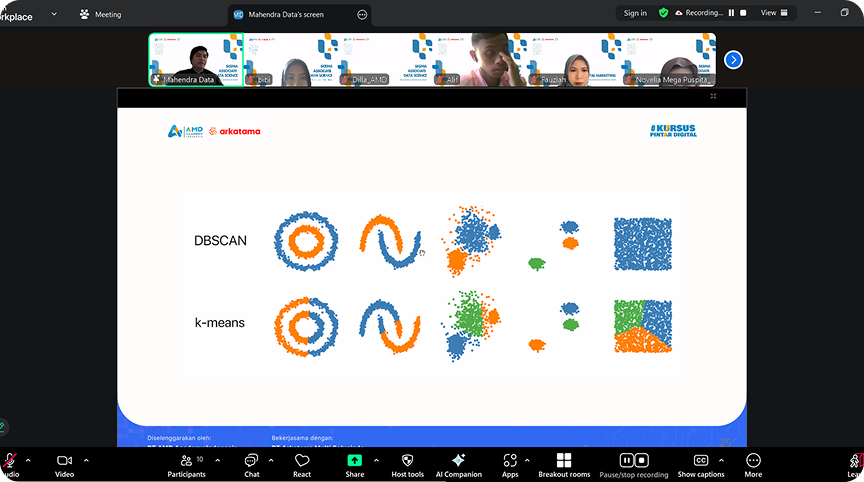
- Unsupervised Learning: Klastering
- Unsupervised Learning: Association Rule Mining
- Unsupervised Learning: Dimensionality Reduction
- Studi Kasus: Proyek Data Science
Benefit yang didapat
- Modul materi pelatihan
- Sertifikat kepesertaan
- Memahami konsep data science, data mining, machine learning, dan kerangka kerja CRISP-DM sebagai fondasi analisis data yang terstruktur
- Mampu memahami kebutuhan bisnis dan karakteristik data sebelum melakukan analisis lebih lanjut
- Mampu melakukan eksplorasi data secara statistik dan visual (EDA) untuk mengungkap pola awal dalam data
- Mampu membangun model regresi untuk memprediksi nilai numerik
- Mampu membangun model peramalan (forecasting)
- Mampu menerapkan algoritma klastering untuk mengelompokkan data berdasarkan kemiripan karakteristik
Colaborator